- 最高票数
- 96
- 最佳排名
- #15
- 上榜次数
- 1 次
- 最近上榜
- 2026.08.10
产品介绍
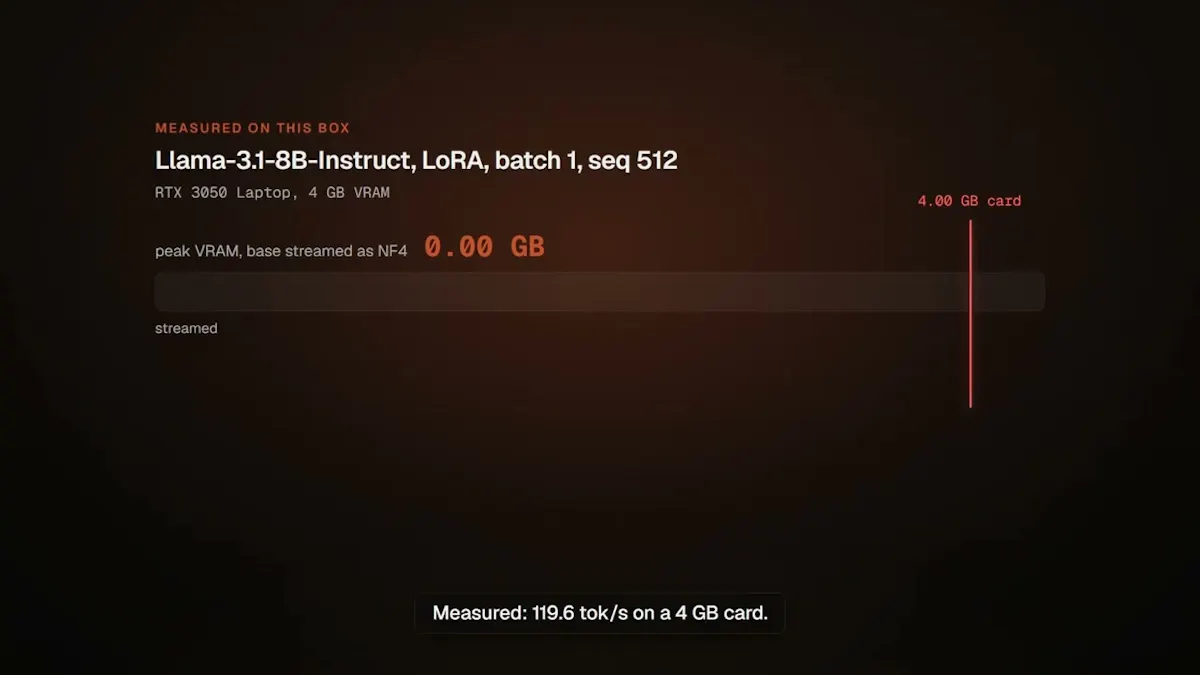
LoRA保持基础模型不变:只读不写。因此,Soup将其保存在系统内存中,并逐层将其传输到GPU中。这样,显存的峰值只需处理一层,而不是整个模型。以RTX 3050 Laptop(4GB显存)为例,Llama-3.1-8B的训练速度为每秒119.6个标记,峰值内存使用为3.32GB。只需一份YAML文件和一个命令。包括SFT、DPO、GRPO、KTO以及评估、门控和导出功能。采用Apache-2.0许可证。每一个数字都已公布,包括那些我测量后舍弃的数字。
- 8B LLM
- 4GB 笔记本 GPU
- LoRA
- 基础模型
- 系统 RAM
- GPU 流式处理
- 解码层
- VRAM
- RTX 3050 笔