- 最高票数
- 100
- 最佳排名
- #15
- 上榜次数
- 1 次
- 最近上榜
- 2026.04.08
产品介绍
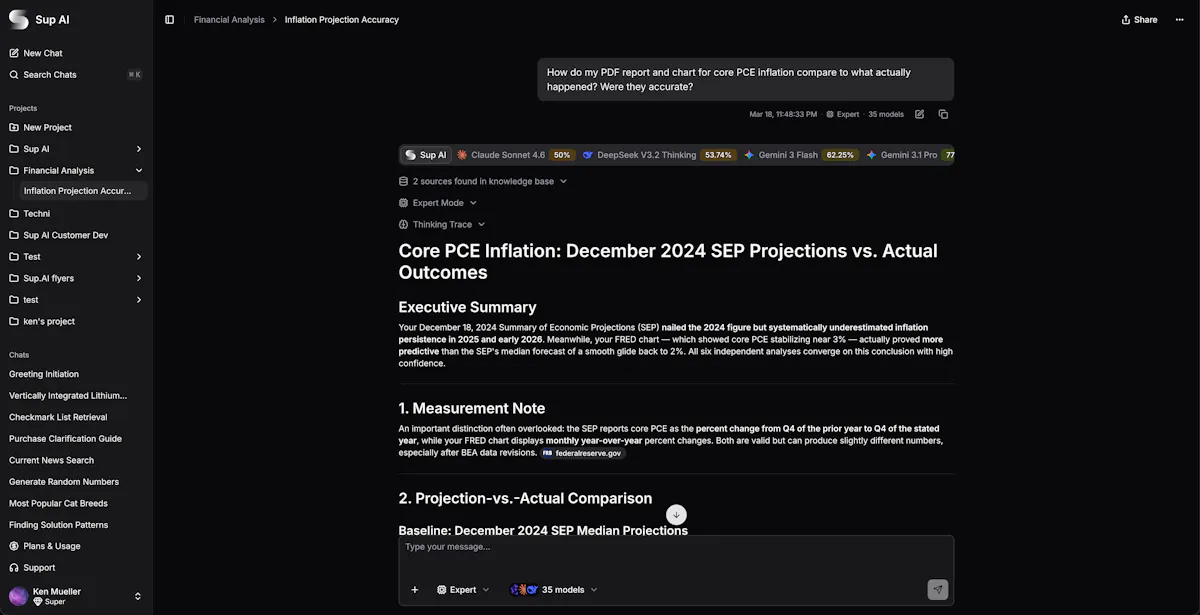
每个大型语言模型(LLM)都会出现“幻觉”,但它们产生的幻觉内容各不相同。Sup AI同时运行339个不同的LLM,通过对每个回答的信心进行测量来综合答案。信心高的回答(低熵)被放大,意味着更有可能准确;而信心低的回答(高熵)则会被削弱,表示可能不太可靠。结果是,在“人类最后的考试”中取得了52.15%的分数,比任何单一模型高出7.41分。现在注册还可以获得10美元的启动信用,卡片已验证,不会自动扣费。
- 人工智能
- LLM
- 高度集成
- 多模型
- 答案合成
- 置信度
- 幻觉
- 精确性
- 人类最后考试
- 52.15%
- 启动