- 最高票数
- 6
- 最佳排名
- #17
- 上榜次数
- 1 次
- 最近上榜
- 2026.05.24
产品介绍
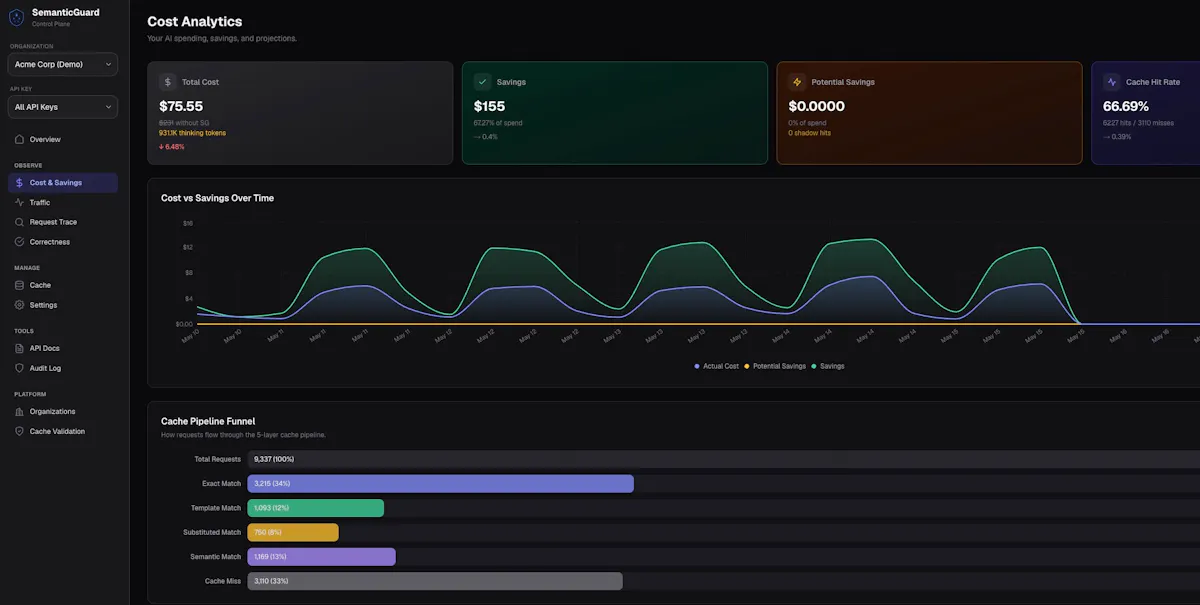
在实际应用中,大部分大型语言模型(LLM)的调用都是重复的。用户提问往往是相似的,虽然表述可能稍有不同。SemanticGuard 可以缓存这些请求,作为你的应用与 OpenAI、Anthropic 或 Google 之间的桥梁,能在不到 50 毫秒的时间内返回缓存结果,并且能减少 40% 到 70% 的成本。只需一行代码就能完成安装。它的“影子模式”可以在你开启缓存之前,先展示你的节省情况。每个返回的结果都经过你自己的人工智能验证,确保不会提供错误的答案。
- LLM API
- 成本节省
- 快速缓存
- 一行代码
- 应用程序
- OpenAI
- Anthropic
- 低延迟
- 影子模式
- 节省展示
- AI